Domain autorenkatalog.de kaufen?
Wir ziehen mit dem Projekt
autorenkatalog.de um.
Sind Sie am Kauf der Domain
autorenkatalog.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain autorenkatalog.de kaufen?
Wo wird das k-means Clustering verwendet?
Das k-means Clustering wird in verschiedenen Bereichen der Datenanalyse und des maschinellen Lernens eingesetzt. Es wird häufig zur Gruppierung von Datenpunkten verwendet, um Muster oder Cluster zu identifizieren. Beispiele für Anwendungen sind die Segmentierung von Kunden in Marketinganalysen, die Klassifizierung von Bildern oder die Analyse von Genexpressionsdaten in der Bioinformatik. **
Wie können Clustering-Algorithmen zur Strukturierung von großen Datenmengen eingesetzt werden? Welche Vorteile bietet das Clustering für die Analyse von Datensätzen?
Clustering-Algorithmen können große Datenmengen in Gruppen mit ähnlichen Merkmalen unterteilen, um Muster und Strukturen zu identifizieren. Durch das Clustering können komplexe Daten vereinfacht und interpretiert werden, um Einblicke und Erkenntnisse zu gewinnen. Dies ermöglicht eine effiziente Analyse von Datensätzen und die Identifizierung von Trends, Mustern und Ausreißern. **


Ähnliche Suchbegriffe für Clustering
Top-Angebote
Produkte zum Begriff Clustering:
-
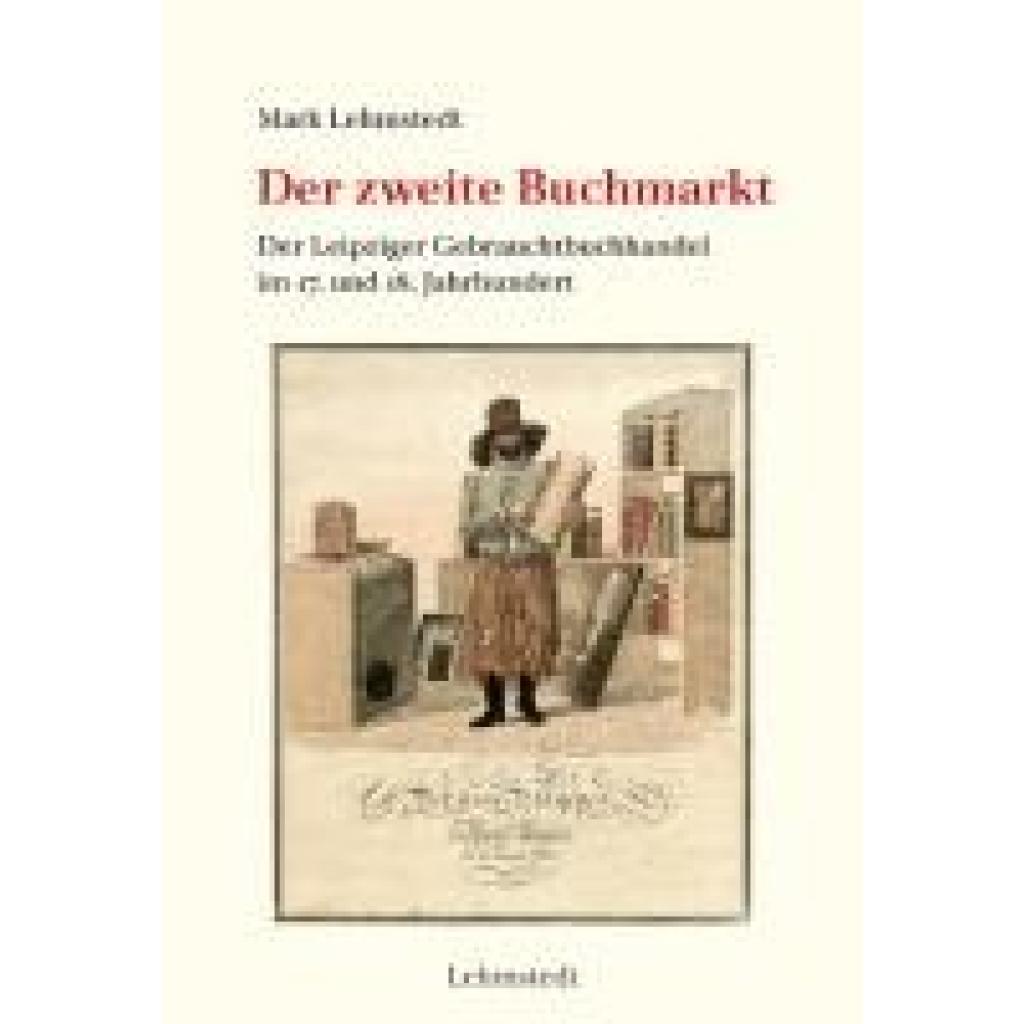
Lehmstedt, Mark: Der zweite BuchmarktDer zweite Buchmarkt , Was geschah mit den Millionen Exemplaren von Büchern, die seit der Erfindung des Buchdrucks in die Welt gekommen sind? Manche wurden ein Opfer von Feuer oder Wasser, andere dienten als Pack- oder Toilettenpapier. Doch schon früh entdeckten Buchhändler, dass man mit gebrauchten Büchern, die in Privatbibliotheken standen oder auf Dachböden verstaubten, ein zweites Mal Geschäfte machen konnte. Der 'zweite Buchmarkt' versorgte Fürsten und Bauern, Gelehrte und Kaufleute, Studenten und Dienstmädchen gleichermaßen mit Lesestoffen, die zudem meist deutlich preiswerter waren als Neuerscheinungen. Der Zugriff auf das in den Büchern der zurückliegenden Jahrhunderte gespeicherte Wissen wurde in einer bis dahin unvorstellbaren Weise erleichtert. Neben dem Antiquariatsbuchhandel bildeten Auktionen die zweite Säule des Handels mit gebrauchten Büchern. Basierend auf einer systematischen Auswertung der Anzeigen in den Leipziger Zeitungen sowie zahlreicher archivalischer Quellen bietet die Bibliografie einen umfassenden Überblick über die Versteigerungen von Büchern in Leipzig zwischen 1670, dem Beginn des Auktionswesens in der Stadt, und dem Jahr 1800. Erfasst sind alle reinen Bücherauktionen sowie alle sonstigen Versteigerungen, bei denen neben Waren aller Art auch Bücher, Gemälde, Kupferstiche, Handzeichnungen, Musikalien, Landkarten sowie Münz- und Naturaliensammlungen unter den Hammer kamen. , Sonstige > Kraftstoffversorgung , Erscheinungsjahr: 20241115, Produktform: Leinen, Inhalt/Anzahl: 1, Titel der Reihe: Buchgeschichte(n)#8#, Autoren: Lehmstedt, Mark, Seitenzahl/Blattzahl: 520, Keyword: Alte Bücher; Antiquare; Antiquariat; Antiquariatsbuchhandel; Auktionsbuchhandel; Buchgeschichte; Buchhandel; Buchmarkt; Bücher; Büchertrödler; Deutschland; Fliegende Händler; Gebrauchte Bücher; Kulturgeschichte; Leipzig; Modernes Antiquariat; Trödel; Verleger, Fachschema: Buchhandel - Buchhändler~Sortimentsbuchhandel, Warengruppe: HC/Geschichte/Sonstiges, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 240, Breite: 165, Höhe: 73, Gewicht: 1000, Produktform: Gebunden, Genre: Geisteswissenschaften/Kunst/Musik,98,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Wie lassen sich Daten mithilfe von Clustering-Algorithmen effizient in Gruppen einteilen? Welche Anwendungsfälle gibt es für Clustering in der Datenanalyse?
Clustering-Algorithmen gruppieren Datenpunkte basierend auf Ähnlichkeiten in Cluster. Dies geschieht durch die Berechnung von Distanzen zwischen den Datenpunkten. Anwendungsfälle für Clustering in der Datenanalyse sind z.B. Kunden-Segmentierung, Anomalieerkennung und Mustererkennung. **
-
Wie kann Clustering dazu beitragen, Muster und Strukturen in großen Datensätzen zu identifizieren? Was sind die Hauptanwendungen von Clustering-Algorithmen in der Datenanalyse?
Clustering gruppiert ähnliche Datenpunkte zusammen, um Muster und Strukturen in großen Datensätzen zu identifizieren. Durch die Identifizierung von natürlichen Gruppierungen können Trends und Zusammenhänge in den Daten aufgedeckt werden. Die Hauptanwendungen von Clustering-Algorithmen in der Datenanalyse sind Segmentierung von Kunden, Mustererkennung in Bildern und Texten, sowie Anomalieerkennung in Sicherheitsdaten. **
-
Wie kann das Clustering-Verfahren dazu beitragen, relevante Muster in großen Datenmengen zu identifizieren? Was sind die Anwendungsmöglichkeiten von Clustering in verschiedenen Branchen?
Das Clustering-Verfahren gruppiert ähnliche Datenpunkte zusammen, um relevante Muster zu identifizieren. Es kann helfen, Trends, Kundenpräferenzen oder Anomalien in großen Datenmengen zu erkennen. Anwendungen von Clustering finden sich in der Marktforschung, Medizin, Finanzwesen und im Bereich der Bildverarbeitung. **
-
Was sind die verschiedenen Methoden für das Clustering von Daten?
Die verschiedenen Methoden für das Clustering von Daten sind k-means, hierarchisches Clustering und DBSCAN. K-means gruppiert Datenpunkte basierend auf deren Ähnlichkeit in k vordefinierte Cluster. Hierarchisches Clustering erstellt eine Baumstruktur von Clustern, während DBSCAN Cluster basierend auf der Dichte der Datenpunkte bildet. **

Was sind die wichtigsten Techniken für das Clustering von Daten?
Die wichtigsten Techniken für das Clustering von Daten sind k-means, hierarchisches Clustering und DBSCAN. K-means gruppiert Datenpunkte basierend auf deren Ähnlichkeit in k vordefinierte Cluster. Hierarchisches Clustering erstellt eine Baumstruktur der Datenpunkte basierend auf deren Ähnlichkeit, während DBSCAN Cluster anhand der Dichte der Datenpunkte bildet. **
Was sind die Vorteile von Clustering-Algorithmen bei der Datenanalyse?
Clustering-Algorithmen helfen dabei, Muster und Strukturen in großen Datensätzen zu identifizieren. Sie ermöglichen eine automatische Gruppierung von ähnlichen Datenpunkten, was eine bessere Datenorganisation und -interpretation ermöglicht. Zudem können sie dabei helfen, unbekannte Zusammenhänge und Trends in den Daten zu entdecken. **
Top-Angebote
Produkte zum Begriff Clustering:
-
Lehmstedt, Mark: Der zweite BuchmarktDer zweite Buchmarkt , Was geschah mit den Millionen Exemplaren von Büchern, die seit der Erfindung des Buchdrucks in die Welt gekommen sind? Manche wurden ein Opfer von Feuer oder Wasser, andere dienten als Pack- oder Toilettenpapier. Doch schon früh entdeckten Buchhändler, dass man mit gebrauchten Büchern, die in Privatbibliotheken standen oder auf Dachböden verstaubten, ein zweites Mal Geschäfte machen konnte. Der 'zweite Buchmarkt' versorgte Fürsten und Bauern, Gelehrte und Kaufleute, Studenten und Dienstmädchen gleichermaßen mit Lesestoffen, die zudem meist deutlich preiswerter waren als Neuerscheinungen. Der Zugriff auf das in den Büchern der zurückliegenden Jahrhunderte gespeicherte Wissen wurde in einer bis dahin unvorstellbaren Weise erleichtert. Neben dem Antiquariatsbuchhandel bildeten Auktionen die zweite Säule des Handels mit gebrauchten Büchern. Basierend auf einer systematischen Auswertung der Anzeigen in den Leipziger Zeitungen sowie zahlreicher archivalischer Quellen bietet die Bibliografie einen umfassenden Überblick über die Versteigerungen von Büchern in Leipzig zwischen 1670, dem Beginn des Auktionswesens in der Stadt, und dem Jahr 1800. Erfasst sind alle reinen Bücherauktionen sowie alle sonstigen Versteigerungen, bei denen neben Waren aller Art auch Bücher, Gemälde, Kupferstiche, Handzeichnungen, Musikalien, Landkarten sowie Münz- und Naturaliensammlungen unter den Hammer kamen. , Sonstige > Kraftstoffversorgung , Erscheinungsjahr: 20241115, Produktform: Leinen, Inhalt/Anzahl: 1, Titel der Reihe: Buchgeschichte(n)#8#, Autoren: Lehmstedt, Mark, Seitenzahl/Blattzahl: 520, Keyword: Alte Bücher; Antiquare; Antiquariat; Antiquariatsbuchhandel; Auktionsbuchhandel; Buchgeschichte; Buchhandel; Buchmarkt; Bücher; Büchertrödler; Deutschland; Fliegende Händler; Gebrauchte Bücher; Kulturgeschichte; Leipzig; Modernes Antiquariat; Trödel; Verleger, Fachschema: Buchhandel - Buchhändler~Sortimentsbuchhandel, Warengruppe: HC/Geschichte/Sonstiges, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 240, Breite: 165, Höhe: 73, Gewicht: 1000, Produktform: Gebunden, Genre: Geisteswissenschaften/Kunst/Musik,98,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wo wird das k-means Clustering verwendet?
Das k-means Clustering wird in verschiedenen Bereichen der Datenanalyse und des maschinellen Lernens eingesetzt. Es wird häufig zur Gruppierung von Datenpunkten verwendet, um Muster oder Cluster zu identifizieren. Beispiele für Anwendungen sind die Segmentierung von Kunden in Marketinganalysen, die Klassifizierung von Bildern oder die Analyse von Genexpressionsdaten in der Bioinformatik. **
-
Wie können Clustering-Algorithmen zur Strukturierung von großen Datenmengen eingesetzt werden? Welche Vorteile bietet das Clustering für die Analyse von Datensätzen?
Clustering-Algorithmen können große Datenmengen in Gruppen mit ähnlichen Merkmalen unterteilen, um Muster und Strukturen zu identifizieren. Durch das Clustering können komplexe Daten vereinfacht und interpretiert werden, um Einblicke und Erkenntnisse zu gewinnen. Dies ermöglicht eine effiziente Analyse von Datensätzen und die Identifizierung von Trends, Mustern und Ausreißern. **
-
Wie lassen sich Daten mithilfe von Clustering-Algorithmen effizient in Gruppen einteilen? Welche Anwendungsfälle gibt es für Clustering in der Datenanalyse?
Clustering-Algorithmen gruppieren Datenpunkte basierend auf Ähnlichkeiten in Cluster. Dies geschieht durch die Berechnung von Distanzen zwischen den Datenpunkten. Anwendungsfälle für Clustering in der Datenanalyse sind z.B. Kunden-Segmentierung, Anomalieerkennung und Mustererkennung. **
-
Wie kann Clustering dazu beitragen, Muster und Strukturen in großen Datensätzen zu identifizieren? Was sind die Hauptanwendungen von Clustering-Algorithmen in der Datenanalyse?
Clustering gruppiert ähnliche Datenpunkte zusammen, um Muster und Strukturen in großen Datensätzen zu identifizieren. Durch die Identifizierung von natürlichen Gruppierungen können Trends und Zusammenhänge in den Daten aufgedeckt werden. Die Hauptanwendungen von Clustering-Algorithmen in der Datenanalyse sind Segmentierung von Kunden, Mustererkennung in Bildern und Texten, sowie Anomalieerkennung in Sicherheitsdaten. **
Ähnliche Suchbegriffe für Clustering
-
Wie kann das Clustering-Verfahren dazu beitragen, relevante Muster in großen Datenmengen zu identifizieren? Was sind die Anwendungsmöglichkeiten von Clustering in verschiedenen Branchen?
Das Clustering-Verfahren gruppiert ähnliche Datenpunkte zusammen, um relevante Muster zu identifizieren. Es kann helfen, Trends, Kundenpräferenzen oder Anomalien in großen Datenmengen zu erkennen. Anwendungen von Clustering finden sich in der Marktforschung, Medizin, Finanzwesen und im Bereich der Bildverarbeitung. **
-
Was sind die verschiedenen Methoden für das Clustering von Daten?
Die verschiedenen Methoden für das Clustering von Daten sind k-means, hierarchisches Clustering und DBSCAN. K-means gruppiert Datenpunkte basierend auf deren Ähnlichkeit in k vordefinierte Cluster. Hierarchisches Clustering erstellt eine Baumstruktur von Clustern, während DBSCAN Cluster basierend auf der Dichte der Datenpunkte bildet. **
-
Was sind die wichtigsten Techniken für das Clustering von Daten?
Die wichtigsten Techniken für das Clustering von Daten sind k-means, hierarchisches Clustering und DBSCAN. K-means gruppiert Datenpunkte basierend auf deren Ähnlichkeit in k vordefinierte Cluster. Hierarchisches Clustering erstellt eine Baumstruktur der Datenpunkte basierend auf deren Ähnlichkeit, während DBSCAN Cluster anhand der Dichte der Datenpunkte bildet. **
-
Was sind die Vorteile von Clustering-Algorithmen bei der Datenanalyse?
Clustering-Algorithmen helfen dabei, Muster und Strukturen in großen Datensätzen zu identifizieren. Sie ermöglichen eine automatische Gruppierung von ähnlichen Datenpunkten, was eine bessere Datenorganisation und -interpretation ermöglicht. Zudem können sie dabei helfen, unbekannte Zusammenhänge und Trends in den Daten zu entdecken. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.